MCP Server : mises à jour de Semantic Search
Modifications
- Fin de la reformulation automatique des requêtes. Auparavant,
semantic_searchgénérait deux formulations supplémentaires en arrière-plan à chaque appel, ce qui ajoutait un appel de modèle caché et de la latence. Ce n'est désormais plus le cas. Pour améliorer le rappel, soumettez vous-même plusieurs formulations — un synonyme, ou la forme développée par rapport à la forme abrégée d'un terme — plutôt que de compter sur le serveur pour les varier. - Signal plus clair lorsqu'un espace de travail n'est pas indexé. Au lieu de renvoyer silencieusement zéro résultat,
semantic_searchindique désormais quand l'indexation n'a pas eu lieu. Si aucun des espaces de travail auxquels vous avez accès n'est indexé, l'appel renvoie une erreur explicite. Si seuls certains ne le sont pas et que votre recherche ne renvoie aucun résultat, la réponse indique désormais quels espaces de travail ont été ignorés — afin qu'une page vide ne soit jamais interprétée à tort comme signifiant « cela n'existe pas dans le catalogue ».
Corrections
- Un enregistrement corrompu ne bloque plus l'ensemble de l'appel. Un enregistrement mal formé dans l'index de recherche pouvait auparavant faire échouer l'intégralité de la requête. Désormais, cet enregistrement est ignoré et le reste de vos résultats est tout de même renvoyé.
- Performances plus stables en cas de forte charge. L'enrichissement des résultats s'exécute désormais avec une concurrence limitée, réduisant les réponses lentes ou incohérentes lorsque le service de catalogue est déjà sollicité.
Correspondance automatique entre les rapports Power BI et votre catalogue
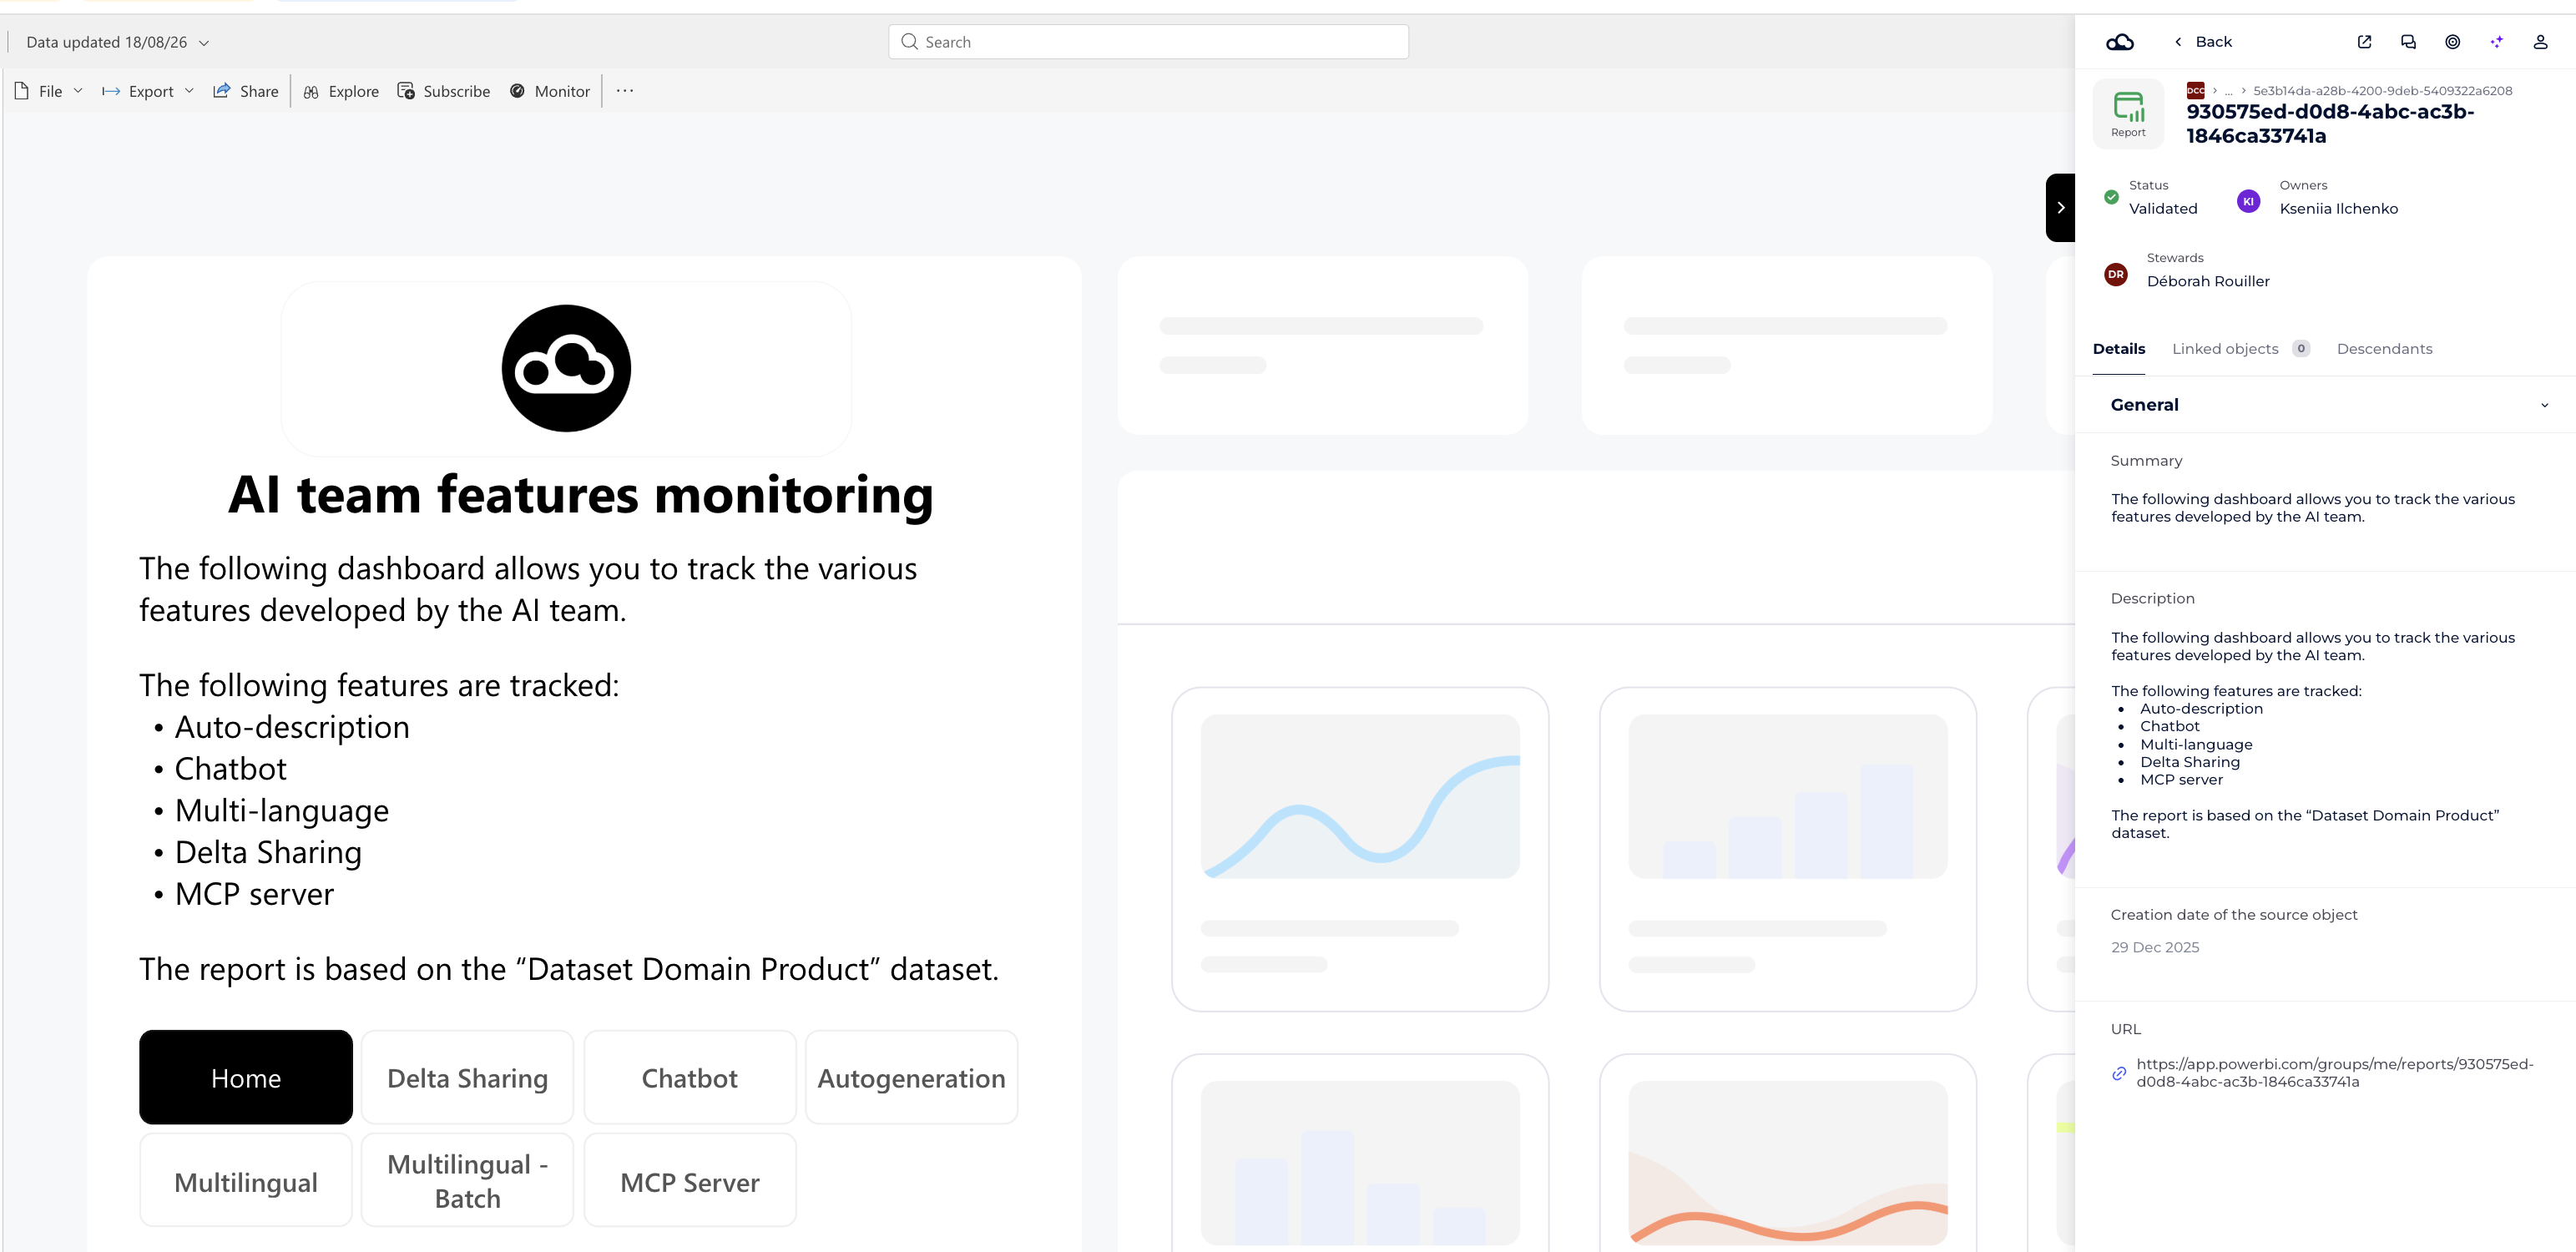
Fini de chercher le bon objet du catalogue à chaque fois que vous ouvrez un rapport Power BI. L'extension DataGalaxy détecte désormais automatiquement et affiche l'objet correspondant pour vous, lorsque cela est possible.
- Correspondance exacte ? L'objet du catalogue correspondant s'ouvre directement dans l'extension.
- Plusieurs correspondances ? Une liste de résultats de recherche apparaît pour que vous puissiez rapidement choisir le bon.
- Envie de comparer ? Cliquez sur l'icône cible pour épingler un objet et naviguer vers d'autres rapports sans le perdre.
Une courte bannière vous présente la fonctionnalité - fermez-la une fois, ou désactivez-la définitivement.
Mise à jour du serveur MCP DataGalaxy
Nous avons déployé une série de mises à jour du serveur MCP DataGalaxy, axées sur une meilleure visibilité des champs, une recherche et des mises à jour plus fiables, ainsi qu'un ensemble d'outils simplifié. Voici les nouveautés, les changements et les corrections.
NOUVEAU
get_object_attributes: permet de voir précisément quels champs sont supportés par un objet du catalogue — s'ils sont modifiables, et pour les champs à liste de valeurs fixe, exactement quelles valeurs sont acceptées. Auparavant, il n'était pas possible de distinguer « ce champ est vide » de « cet objet ne possède pas ce champ ». Cette lacune est désormais comblée.get_objectpeut désormais indiquer la couverture des champs : en activant une option,get_objectpeut également renvoyer la liste des champs supportés par l'objet et ceux qui sont actuellement vides — les mêmes informations queget_object_attributes, intégrées directement dans la recherche d'objet principale. Cette option est désactivée par défaut, donc les recherches classiques ne sont pas impactées.
MODIFIÉ
update_objectprend désormais une liste unique et plate de champs à modifier — par exemple{"status": "Validated", "Business Domain": "Finance"}— en utilisant les mêmes noms de champs que ceux affichés parget_object, qu'il s'agisse d'un champ standard ou d'un champ personnalisé de votre organisation. Cela remplace l'ancien système où champs standards et champs personnalisés devaient être transmis différemment, source fréquente de confusion et d'erreurs. Action requise : toute intégration appelant directementupdate_objectdevra être adaptée à ce nouveau format.La portée de la recherche est désormais explicite : les paramètres
workspace_idetversion_idsont maintenant transmis directement àsearch_objectsetsemantic_search, plutôt que d'être déduits des paramètres de connexion. Cela permet un comportement de recherche identique pour chaque client connecté au serveur, et permet de rechercher dans l'ensemble des workspaces auxquels vous avez accès en une seule requête, simplement en omettant ces deux paramètres.search_objectsn'accepte plus le paramètreincluded_attributes: en pratique, les valeurs acceptées par ce paramètre variaient selon le workspace, sans moyen pour l'appelant de les découvrir, ce qui provoquait systématiquement des erreurs difficiles à diagnostiquer en cas de valeur incorrecte. L'ensemble des champs renvoyés par la recherche est désormais fixe et documenté ; utilisezget_object(ou le nouveauget_object_attributes) lorsque vous avez besoin de davantage d'informations.Quatre outils historiques retirés :
get_object_details,get_ancestors,get_linked_objectsetget_object_fieldsont été supprimés. Leurs fonctionnalités sont désormais couvertes parget_object(vue d'ensemble complète de l'objet) etget_object_relations(parcours d'une relation spécifique — liens, enfants, champs ou ancêtres).get_object_tagsa également été retiré ; les informations de tags sont désormais incluses dansget_object.natural_language_searcha été supprimé : cet outil traduisait des questions en langage libre en filtres de recherche à partir d'un vocabulaire limité, et retombait silencieusement sur une recherche non filtrée et peu précise pour tout ce qui sortait de ce vocabulaire.search_objectsetsemantic_searchcouvrent désormais ce besoin de manière plus fiable.
CORRIGÉ
- La mise à jour d'un objet pouvait échouer silencieusement lorsque le champ modifié n'était en réalité pas disponible sur cet objet précis — la requête renvoyait un succès sans qu'aucune modification n'ait eu lieu. Ce cas est désormais détecté avant l'envoi de la requête, avec un message d'erreur clair indiquant les champs réellement disponibles.
- L'affichage de la hiérarchie parentale complète d'un objet pouvait, à tort, signaler l'objet comme introuvable pour tout objet autre qu'un objet de premier niveau. Ce problème est corrigé.
- Les libellés des types d'objets pouvaient légèrement varier selon l'outil utilisé (notamment pour certains types d'objets de bases de données et d'applications), ce qui pouvait affecter l'affichage d'informations liées, comme la catégorie d'un objet ou ses éléments enfants attendus. Les libellés sont désormais cohérents partout.
- Des messages d'erreur internes pouvaient occasionnellement apparaître dans la réponse au lieu d'un message d'erreur clair et générique. Ce problème est désormais résolu.
- Les listes de résultats volumineuses sont désormais résumées de manière plus fiable, afin qu'un nombre de résultats affiché corresponde toujours à ce qui est réellement montré.
Note pour les utilisateurs de Blink : Blink étant également construit sur ce serveur MCP, ces changements — combinés aux corrections précédentes — bénéficient directement à Blink, améliorant la précision et la fiabilité de ses réponses.
La mise en forme du texte enrichi est désormais préservée à l'export et à l'import
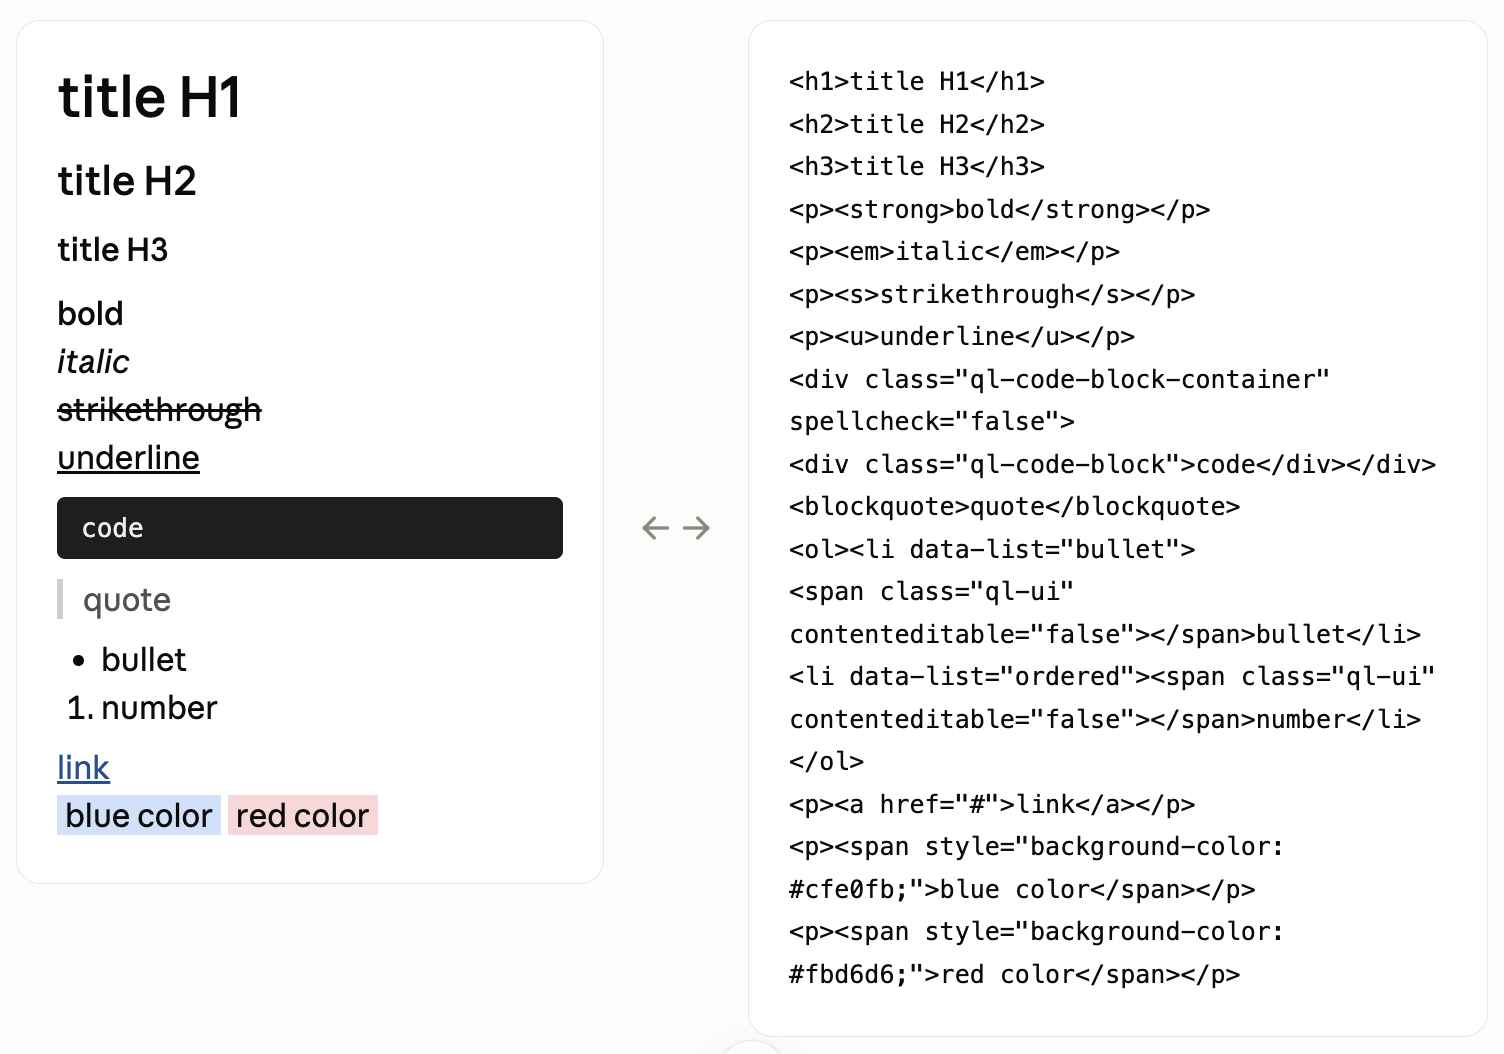
Auparavant, l'export de champs de texte contenant du contenu enrichi (gras, italique, listes, liens, etc.) convertissait tout en texte brut — la mise en forme était donc perdue dès la réimportation du CSV.
C'est désormais corrigé.
Les champs de texte enrichi sont exportés en HTML, ce qui préserve toute la mise en forme lors de la réimportation dans le catalogue. Vous pouvez maintenant exporter, modifier en externe, puis réimporter sans perdre votre travail.
La prise en charge du texte enrichi dans l'API arrivera prochainement.
Merci de vérifier le plan de déploiement avec votre chargé de compte.